4b.使用框架的各种代码示例(高级进阶)
4b.1 日志模板中自动显示task_id
4b.1.1 日志模板中显示task_id
在 funboost_config.py 中设置如下(43.0 版本以后默认就是带 task_id 的模板了):
import logging
from nb_log import nb_log_config_default
class FunboostCommonConfig(DataClassBase):
    NB_LOG_FORMATER_INDEX_FOR_CONSUMER_AND_PUBLISHER = logging.Formatter(
        f'%(asctime)s-({nb_log_config_default.computer_ip},{nb_log_config_default.computer_name})-[p%(process)d_t%(thread)d] - %(name)s - "%(filename)s:%(lineno)d" - %(funcName)s - %(levelname)s - %(task_id)s - %(message)s',
        "%Y-%m-%d %H:%M:%S",)

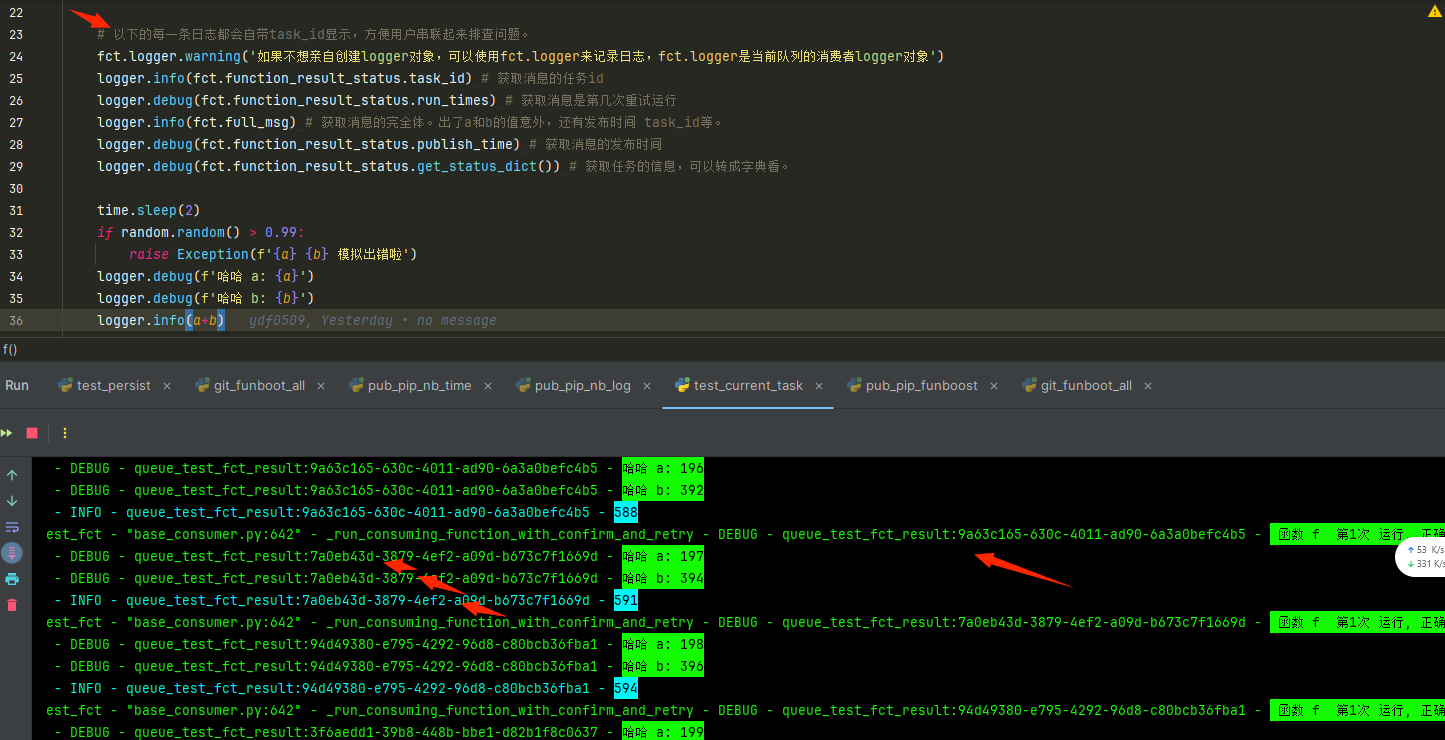
4b.1.2 用户在消费函数中想自动显示task_id,方便搜索task_id的关键字来排查某条消息的所有日志.
关键是用户需要设置 logger_cls=TaskIdLogger。
代码链接: test_current_task.py
import random
import time
from funboost import boost, FunctionResultStatusPersistanceConfig, BoosterParams, fct
from funboost.core.task_id_logger import TaskIdLogger
import nb_log
from funboost.funboost_config_deafult import FunboostCommonConfig
from nb_log import LogManager

LOG_FILENAME_QUEUE_FCT = 'queue_fct.log'
task_id_logger = LogManager('namexx', logger_cls=TaskIdLogger).get_logger_and_add_handlers(
    log_filename='queue_fct.log',
    error_log_filename=nb_log.generate_error_file_name(LOG_FILENAME_QUEUE_FCT),
    formatter_template=FunboostCommonConfig.NB_LOG_FORMATER_INDEX_FOR_CONSUMER_AND_PUBLISHER, )

common_logger = nb_log.get_logger('namexx2', formatter_template=FunboostCommonConfig.NB_LOG_FORMATER_INDEX_FOR_CONSUMER_AND_PUBLISHER)


@boost(BoosterParams(queue_name='queue_test_fct', qps=2, concurrent_num=5, log_filename=LOG_FILENAME_QUEUE_FCT))
def f(a, b):
    fct.logger.warning('使用fct.logger记录日志,自动带task_id')
    task_id_logger.info(fct.function_result_status.task_id)
    task_id_logger.debug(fct.function_result_status.run_times)
    task_id_logger.info(fct.full_msg)
    task_id_logger.debug(fct.function_result_status.publish_time_format)

    common_logger.debug('非TaskIdLogger需手动传extra', extra={'task_id': fct.task_id})

    time.sleep(2)
    if random.random() > 0.99:
        raise Exception(f'{a} {b} 模拟出错啦')
    return a + b


if __name__ == '__main__':
    for i in range(0, 200):
        f.push(i, b=i * 2)
    f.consume()
4b.1.3 一键全局使用 TaskIdLogger 代替 logging.Logger 的方式
import logging
from funboost.core.task_id_logger import TaskIdLogger
logging.setLoggerClass(TaskIdLogger)  # 越早运行越好
4b.1.4 能在消费函数的整个链路里面的调用的任意函数获取task_id的原理
fct 是线程/协程级别隔离的上下文对象,函数调用链中的任意位置都能通过 fct.task_id 获取当前任务 ID。
4b.2 支持消费函数定义入参 **kwargs ,用于消费包含随机不确定keys(或者keys太多了)的json消息
funboost 在异构消息兼容性方面远超 Celery,见本节和 4b.2c 章节。
4b.2.0 funboost函数执行一条消息的最根本原理是 fun(**消息字典)
funboost push 的背后:
假设消费函数签名是 def task_fun(a,b,c,d,e):pass ,
那么 task_fun.push(1,2,3,4,5) 会把 {"a":1,"b":2,"c":3,"d":4,"e":5} 转成json发到消息队列。
掌握此原理就知道怎么消费任意非funboost发布的已存在json消息了:
例如别的部门发布了 {"a":1,"b":2,"c":3,"d":4,"e":5} 到消息队列,
消费函数定义成 def task_fun(a,b,c,d,e):pass 即可消费。

如果字段太多或json的keys会变化:
方式一:def task_fun(**kwargs):pass  接受不定项keys
方式二:def task_fun(my_msg):pass + _user_convert_msg_before_run 转化
4b.2.1 演示错误的消费已存在json消息的例子
面对已存在的消息 {"a":1,"b":2,"c":3,"d":4,"e":5}:

1) 正确:def task_fun(a,b,c,d,e):pass — keys和入参一一对应
2) 正确:def task_fun(**message):pass — **message接受不定项入参
3) 错误:def task_fun(message):pass — keys和入参不匹配,除非使用 _user_convert_msg_before_run 转化
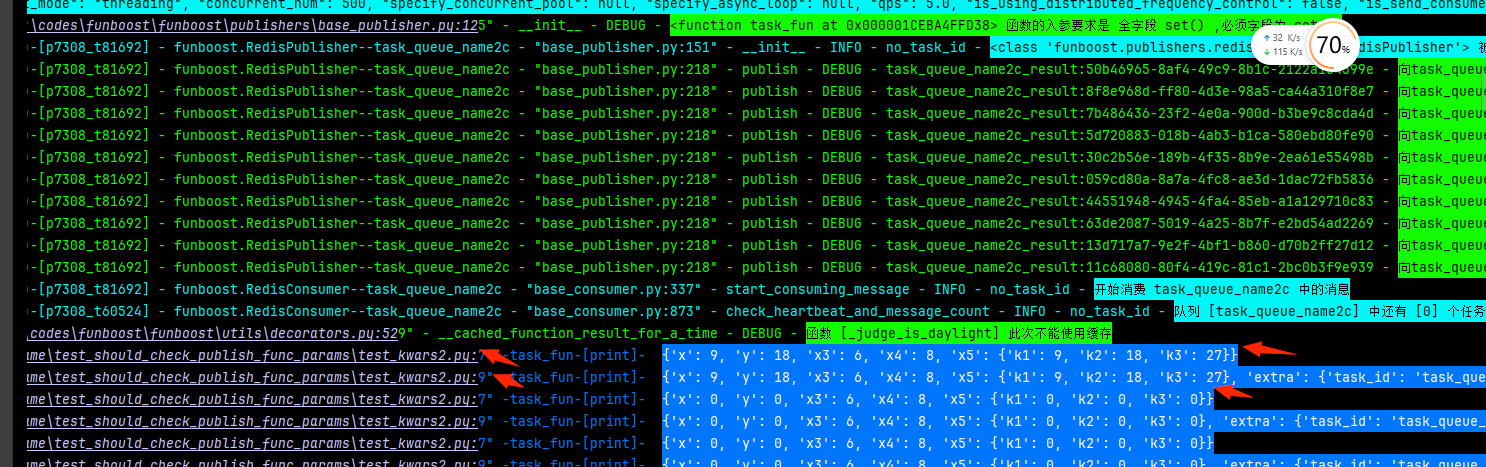
4b.2.3 方式一: 使用 **kwargs 方式消费随机keys
设置 should_check_publish_func_params=False 让 publisher 不再校验发布入参:
import time
import redis
import json
from funboost import boost, BrokerEnum, BoosterParams, fct

@boost(BoosterParams(queue_name="task_queue_name2c", qps=5,
                     broker_kind=BrokerEnum.REDIS,
                     log_level=10, should_check_publish_func_params=False))
def task_fun(**kwargs):
    print(kwargs)
    print(fct.full_msg)
    time.sleep(3)


if __name__ == "__main__":
    redis_conn = redis.Redis(db=7)
    for i in range(10):
        task_fun.publish(dict(x=i, y=i * 2, x3=6, x4=8, x5={'k1': i, 'k2': i * 2, 'k3': i * 3}))
        task_fun.publisher.send_msg(dict(y1=i, y2=i * 2, y3=6, y4=8, y5={'k1': i, 'k2': i * 2, 'k3': i * 3}))
        redis_conn.lpush('task_queue_name2c', json.dumps({"m": 666, "n": 777}))

    task_fun.consume()
4b.2.4 方式二: 使用 _user_convert_msg_before_run 方式
import typing
from funboost import AbstractConsumer, BoosterParams

class MyTooManyKeysJsonConvetConsumer(AbstractConsumer):
    def _user_convert_msg_before_run(self, msg) -> typing.Union[dict, str]:
        return {"my_msg": json.loads(msg)}

@BoosterParams(..., consumer_override_cls=MyTooManyKeysJsonConvetConsumer)
def task_fun(my_msg):
    print(my_msg)
4b.2c 更强力灵活的,funboost支持消费地球上一切任意格式的不规范消息(非json格式也能消费)
funboost 默认要求消息是 JSON 格式(内部通过 task_fun(**json.loads(json_str)) 调用)。但通过 _user_convert_msg_before_run,非 JSON 消息也能消费。
实现方式:
继承
AbstractConsumer,重写_user_convert_msg_before_run方法装饰器设置
consumer_override_cls参数(详见文档 4.21 章节)
4b.2c.1 例如funboost消费消息队列中已存在的消息 'a=1,b=2' 这种.
import typing
import redis
from funboost import BrokerEnum, BoosterParams, AbstractConsumer


class MyAnyMsgConvetConsumer(AbstractConsumer):
    def _user_convert_msg_before_run(self, msg) -> typing.Union[dict, str]:
        new_msg = {}
        for item in msg.split(','):
            key, value = item.split('=')
            new_msg[key] = int(value)
        self.logger.debug(f'原来消息是:{msg},转换成的新消息是:{new_msg}')
        return new_msg


@BoosterParams(queue_name="task_queue_consume_any_msg", broker_kind=BrokerEnum.REDIS,
               consumer_override_cls=MyAnyMsgConvetConsumer)
def task_fun(a: int, b: int):
    print(f'a:{a},b:{b}')
    return a + b


if __name__ == "__main__":
    redis_conn = redis.Redis(db=7)
    redis_conn.lpush('task_queue_consume_any_msg', 'a=1,b=2')
    task_fun.publisher.send_msg('a=3,b=4')
    task_fun.consume()
4b.2c.2 例如,funboost消费队列中已存在的 "1000123"(纯粹用户id) 这种非json消息
class MyUserIDMsgConvetConsumer(AbstractConsumer):
    def _user_convert_msg_before_run(self, msg) -> typing.Union[dict, str]:
        return {"user_id": int(msg)}

@BoosterParams(..., consumer_override_cls=MyUserIDMsgConvetConsumer)
def task_fun(user_id: int):
    pass
典型应用场景:funboost 可以消费
canal/Debezium/Maxwell/flink cdc发到 kafka 的 binlog 消息,Celery 无法做到。funboost 可以用def fun(**canal_message)直接消费,或通过_user_convert_msg_before_run转换。
4b.3 funboost + 全asyncio 编程生态演示
funboost 对 asyncio 编程生态的直接性支持远超 Celery:消费支持 async def 函数、发布支持 aio_push、RPC 结果获取支持 AioAsyncResult。
代码例子: full_asyncio_demo
4b.3.1 funboost 天然支持 async def 的消费函数,和支持 aio_push 来异步发布消息.
concurrent_mode=ConcurrentModeEnum.THREADING 和 ConcurrentModeEnum.ASYNC 都支持 async def 函数。
import asyncio
import time
from funboost import boost, BrokerEnum, ConcurrentModeEnum, BoosterParams

@boost(BoosterParams(queue_name='aio_long_time_fun_queue', is_using_rpc_mode=True,
                     concurrent_mode=ConcurrentModeEnum.ASYNC))
async def aio_long_time_fun(x):
    await asyncio.sleep(10)
    print(f'aio_long_time_fun {x}')
    return f'aio_long_time_fun {x}'

@boost(BoosterParams(queue_name='long_time_fun_queue', is_using_rpc_mode=True))
def long_time_fun(x):
    time.sleep(5)
    print(f'long_time_fun {x}')
    return f'long_time_fun {x}'


if __name__ == '__main__':
    async def aio_push_msg():
        for i in range(10):
            await aio_long_time_fun.aio_push(i)
    asyncio.run(aio_push_msg())

    for j in range(10):
        long_time_fun.push(j)

    aio_long_time_fun.consume()
    long_time_fun.consume()
4b.3.2 演示fastapi 中aio_push来发布消息,和 AioAsyncResult asyncio方式 等待获取结果.
from fastapi import FastAPI
from funboost import AioAsyncResult
from consume_fun import aio_long_time_fun, long_time_fun

app = FastAPI()

@app.get("/url1/{name}")
async def api1(name: str):
    async_result = long_time_fun.push(name)
    return {"result": await AioAsyncResult(async_result.task_id).status_and_result}

@app.get("/url2/{name}")
async def api2(name: str):
    asio_async_result = await aio_long_time_fun.aio_push(name)
    return {"result": await asio_async_result.result}

if __name__ == "__main__":
    import uvicorn
    uvicorn.run(app, host="0.0.0.0", port=8000)
警告:千万别在 fastapi 异步接口中使用同步的
AsyncResult.result,会阻塞整个 event loop。
4b.3.3 关于funboost的asyncio生态支持实现原理的答疑
消费怎么支持 async def 函数并发?
THREADING模式:每个线程内部有单独 loop,用loop.run_until_complete运行协程。使用的并发池是FlexibleThreadPool(作者开发的可变线程池)。ASYNC模式:真正让协程任务运行在同一个 loop 中。使用的并发池是AsyncPoolExecutor(专用 asyncio 协程池)。
为什么源码的消息队列包都是同步的?
因为每个队列在一个进程里只有一个线程拉取消息,不存在并发拉取,无需异步包。
aio_push 怎么实现的?
使用 loop.run_in_executor 将同步发布转为异步,无需异步消息队列包。
AioAsyncResult 怎么实现的?
使用 redis.asyncio.Redis 异步 Redis 操作类获取 RPC 结果。
4b.3.4 关于asyncio编程的建议
funboost 对 async def 的直接内置支持远超 Celery,但不鼓励非专业资深开发者使用 async def 定义消费函数。
建议使用 asyncio 的场景:用户已有 asyncio 生态工具包(如 fastapi + aiohttp),所有可复用函数已是 async 写法。
funboost 中使用 asyncio 比 fastapi 更难:FastAPI 在主线程中运行 loop,funboost 是在子线程中运行不同的 loop,涉及跨线程 asyncio 对象共享问题——这是 asyncio 最复杂的应用场景之一。
funboost 默认的 THREADING 模式使用作者开发的
FlexibleThreadPool,不仅支持同步函数,还能自动兼容运行 async def 函数,用户无需像 Celery 那样手写asyncio.new_event_loop().run_until_complete(async_func())的包装代码。
4b.3.5 演示funboost解决 ,async并发模式,由于跨线程loop 操作任何socket连接池 的报错,
使用 specify_async_loop 即可解决。详见文档 6.26 章节。
经典报错:attached to a different loop 和 context manager should be used inside a task
ASYNC 并发模式第一性原理:
funboost 的 ASYNC 模式使用 AsyncPoolExecutor,它启动一个线程,使用传递的 specify_async_loop(不传则新创建 loop),在该 loop 中并发运行 concurrent_num 个协程。如果用户的连接池绑定了主线程的 loop,在子线程的新 loop 中使用会报错——这就是需要 specify_async_loop 的原因。
4b.4 等待n个任务完成后,再做下一步操作(其实就是canvas任务编排)
借助 RPC 等待结果阻塞的特性实现(也可用 4.17 章节的 wait_for_possible_has_finish_all_tasks):
import time
from funboost import BoosterParams, BrokerEnum

@BoosterParams(queue_name='test_rpc_queue_a1', is_using_rpc_mode=True, broker_kind=BrokerEnum.REDIS_ACK_ABLE, qps=2, max_retry_times=5)
def f1(x):
    time.sleep(5)
    async_result_list = [f2.push(x + i) for i in range(10)]
    for async_result in async_result_list:
        async_result.set_timeout(300)
        print(async_result.task_id, async_result.status_and_result, async_result.result)
    print('f2 10个任务都完成了,现在开始进行下一步')


@BoosterParams(queue_name='test_rpc_queue_a2', is_using_rpc_mode=True,
               broker_kind=BrokerEnum.REDIS_ACK_ABLE, qps=5, max_retry_times=5)
def f2(y):
    time.sleep(10)
    return y * 10


if __name__ == '__main__':
    f1.consume()
    f2.consume()
    for j in range(20):
        f1.push(j)
4b.5 funboost 原生任务编排(实现canvas功能)
tips:用户可对比 4b.8 章节的声明式编排语法。
funboost 命令式编排:使用 RPC 阻塞等待结果,无需学习新的 DSL 语法,全部使用已有的 .push() / .aio_push() 和 .wait_rpc_data_or_raise() 方法。
import typing
import time
from funboost import (boost, BoosterParams, BrokerEnum, ConcurrentModeEnum,
                      AsyncResult, FunctionResultStatus, AioAsyncResult, fct)


class MyBoosterParams(BoosterParams):
    is_using_rpc_mode: bool = True
    broker_exclusive_config: dict = {'pull_msg_batch_size': 1}
    broker_kind: str = BrokerEnum.REDIS_ACK_ABLE
    max_retry_times: int = 0


@boost(MyBoosterParams(queue_name='download_video_queue'))
def download_video(url):
    time.sleep(5)
    download_file = f'/dir/vd0/{url}'
    fct.logger.info(f'下载视频 {url} 完成, 保存到 {download_file}')
    return download_file


@boost(MyBoosterParams(queue_name='transform_video_queue'))
def transform_video(video_file, resolution='360p'):
    time.sleep(10)
    transform_file = f'{video_file}_{resolution}'
    fct.logger.info(f'转码视频 {video_file} 完成, 保存到 {transform_file}')
    return transform_file


@boost(MyBoosterParams(queue_name='send_finish_msg_queue'))
def send_finish_msg(transform_video_file_list: list, url):
    time.sleep(2)
    fct.logger.info(f'发送通知 {url} 转码完成 {transform_video_file_list}')
    return f'ok! {url} 完成'


@boost(MyBoosterParams(queue_name='canvas_task_queue', concurrent_num=500))
def canvas_task(url):
    """命令式编排:显式传递结果,可加 if/else 判断"""
    r1: AsyncResult = download_video.push(url).set_timeout(1000)
    rpc_res_file: FunctionResultStatus = r1.wait_rpc_data_or_raise(raise_exception=True)

    r2_list: typing.List[AsyncResult] = [transform_video.push(rpc_res_file.result, resolution=rel)
                                          for rel in ['360p', '720p', '1080p']]
    rpc_res_list = AsyncResult.batch_wait_rpc_data_or_raise(r2_list, raise_exception=True)
    transform_video_file_list = [one.result for one in rpc_res_list]

    r3 = send_finish_msg.push(transform_video_file_list, url)
    return r3.wait_rpc_data_or_raise(raise_exception=True).result


@boost(MyBoosterParams(queue_name='aio_canvas_task_queue',
                       concurrent_mode=ConcurrentModeEnum.ASYNC, concurrent_num=500))
async def aio_canvas_task(url):
    """asyncio 版本编排:减少线程占用"""
    r1: AioAsyncResult = await download_video.aio_push(url)
    rpc_res_file: FunctionResultStatus = await r1.wait_rpc_data_or_raise(raise_exception=True)

    r2_list: typing.List[AioAsyncResult] = [(await transform_video.aio_push(rpc_res_file.result, resolution=rel)).set_timeout(2000)
                                             for rel in ['360p', '720p', '1080p']]
    rpc_res_list = await AioAsyncResult.batch_wait_rpc_data_or_raise(r2_list, raise_exception=True)
    transform_video_file_list = [one.result for one in rpc_res_list]

    r3 = await send_finish_msg.aio_push(transform_video_file_list, url)
    return (await r3.wait_rpc_data_or_raise(raise_exception=True)).result


if __name__ == '__main__':
    download_video.consume()
    transform_video.consume()
    send_finish_msg.consume()
    canvas_task.consume()
    aio_canvas_task.consume()

    r4_a = canvas_task.push(f'funboost_url_video_a')
    print(r4_a.wait_rpc_data_or_raise(raise_exception=False).to_pretty_json_str())
4b.6 @boost装饰器 user_options 入参的妙用
user_options 是用户域传参(字典),用户可自由发挥,无需修改 BoosterParams 源码。
user_options 提供了统一的用户自定义命名空间,让用户为"特殊需求"传递配置,无需等待框架开发者添加官方支持。

场景1:假设框架不内置 consume_group,可传递 user_options={'booster_group': 'group1'} 自行实现分组启动
场景2:项目需要操作多个 kafka 集群,可通过 user_options 传递不同集群地址,配合 consumer_override_cls 实现
4b.6.1 场景一:user_options "反向实现" consume_group
from funboost import boost, BoosterParams, BoostersManager

@boost(BoosterParams(queue_name="q1", user_options={'module': 'billing'}))
def process_payment(payment_id): ...

@boost(BoosterParams(queue_name="q2", user_options={'module': 'billing'}))
def generate_invoice(invoice_id): ...

if __name__ == '__main__':
    for queue_name in BoostersManager.get_all_queues():
        booster = BoostersManager.get_booster(queue_name)
        if booster.boost_params.user_options.get('module') == 'billing':
            booster.consume()
4b.6.2 场景二:user_options 多租户与覆盖全局配置(以Kafka集群为例)
@boost(BoosterParams(
    queue_name='special_auditing_task',
    consumer_override_cls=CustomKafkaConsumer,
    user_options={'kafka_bootstrap_servers': '10.0.0.100:9092,10.0.0.101:9092'}
))
def auditing_task(data): ...
在自定义消费者中优先读取 user_options:
class CustomKafkaConsumer(KafkaConsumerManuallyCommit):
    def _dispatch_task(self):
        bootstrap_servers = self.consumer_params.user_options.get(
            'kafka_bootstrap_servers',
            BrokerConnConfig.KAFKA_BOOTSTRAP_SERVERS
        )
        self._confluent_consumer = ConfluentConsumer({
            'bootstrap.servers': ','.join(bootstrap_servers),
        })
4b.7 opentelemetry 全链路任务追踪(高级功能)
使用方式:直接使用 OtelBoosterParams,或在 BoosterParams 中指定 consumer_override_cls 和 publisher_override_cls。
from funboost.contrib.override_publisher_consumer_cls.funboost_otel_mixin import OtelBoosterParams
from funboost import boost

@boost(OtelBoosterParams(queue_name='otel_demo_task_process'))
def fun(x, y):
    return x + y
可选功能,funboost 默认不开启
采用国际 W3C 规范的
opentelemetry协议,支持跨项目、跨语言、跨 HTTP 服务的全链路追踪代码实现:
funboost/contrib/override_publisher_consumer_cls/funboost_otel_mixin.py使用demo:
test_frame/test_otel
4b.7.1 安装 jaeger ,可视化展示 opentelemetry 的全链路追踪
docker run -d --name jaeger \
  -e COLLECTOR_OTLP_ENABLED=true \
  -p 16686:16686 \
  -p 4317:4317 \
  -p 4318:4318 \
  jaegertracing/all-in-one:latest
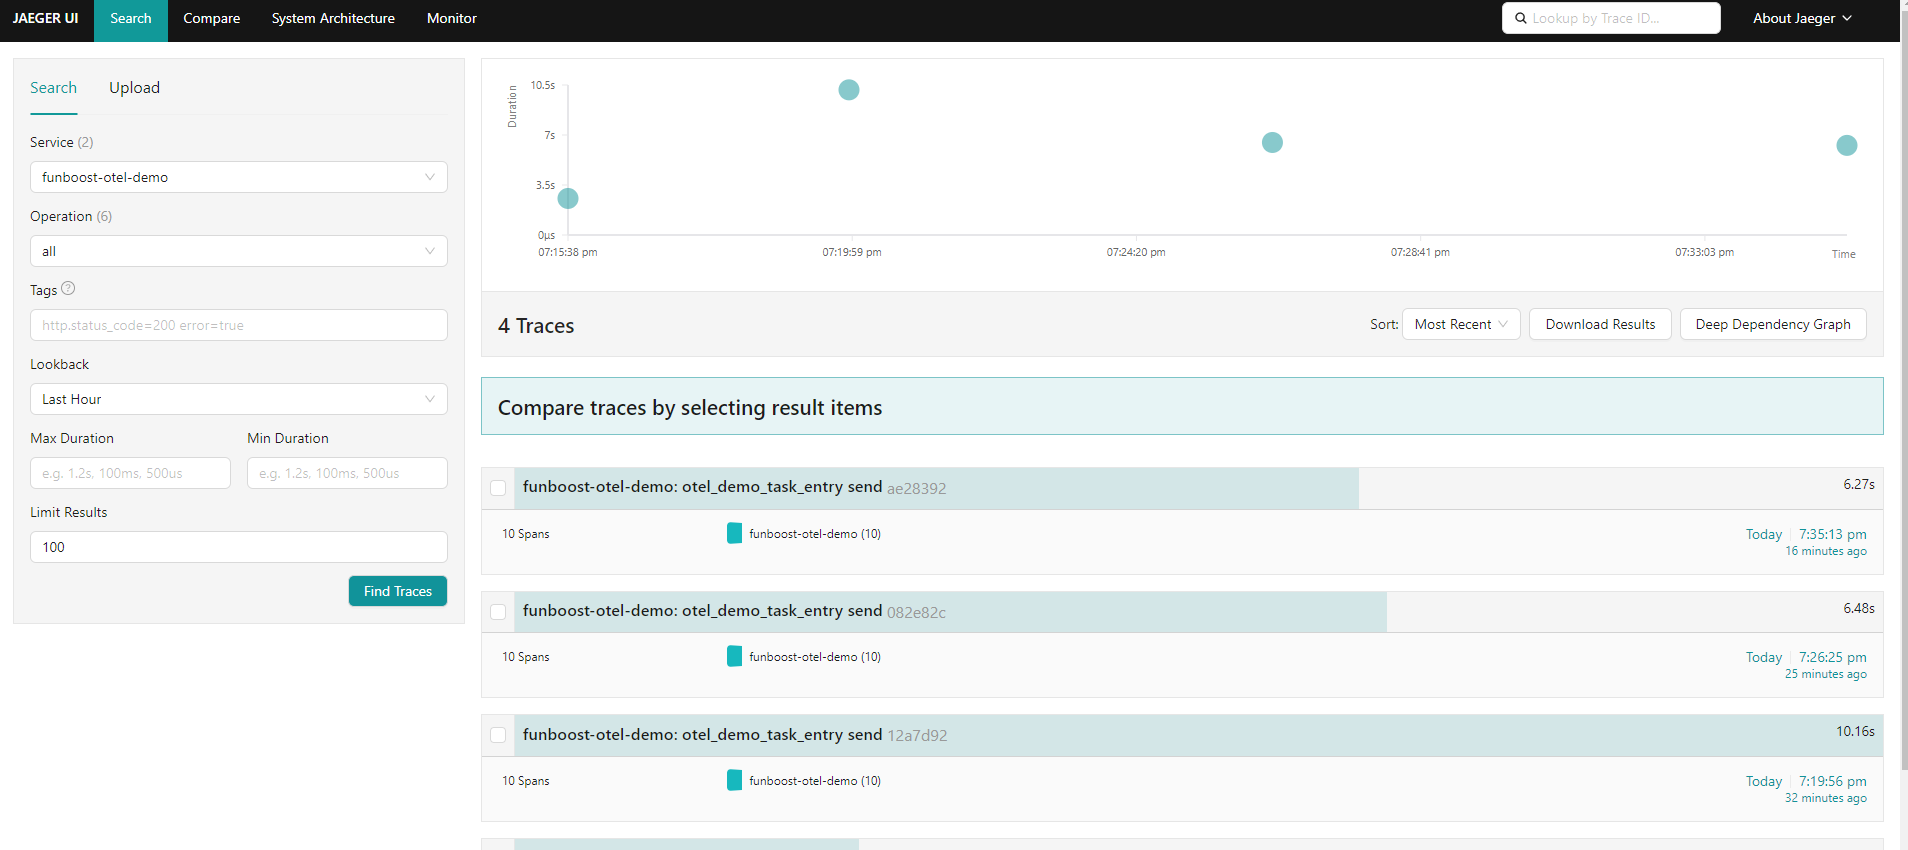
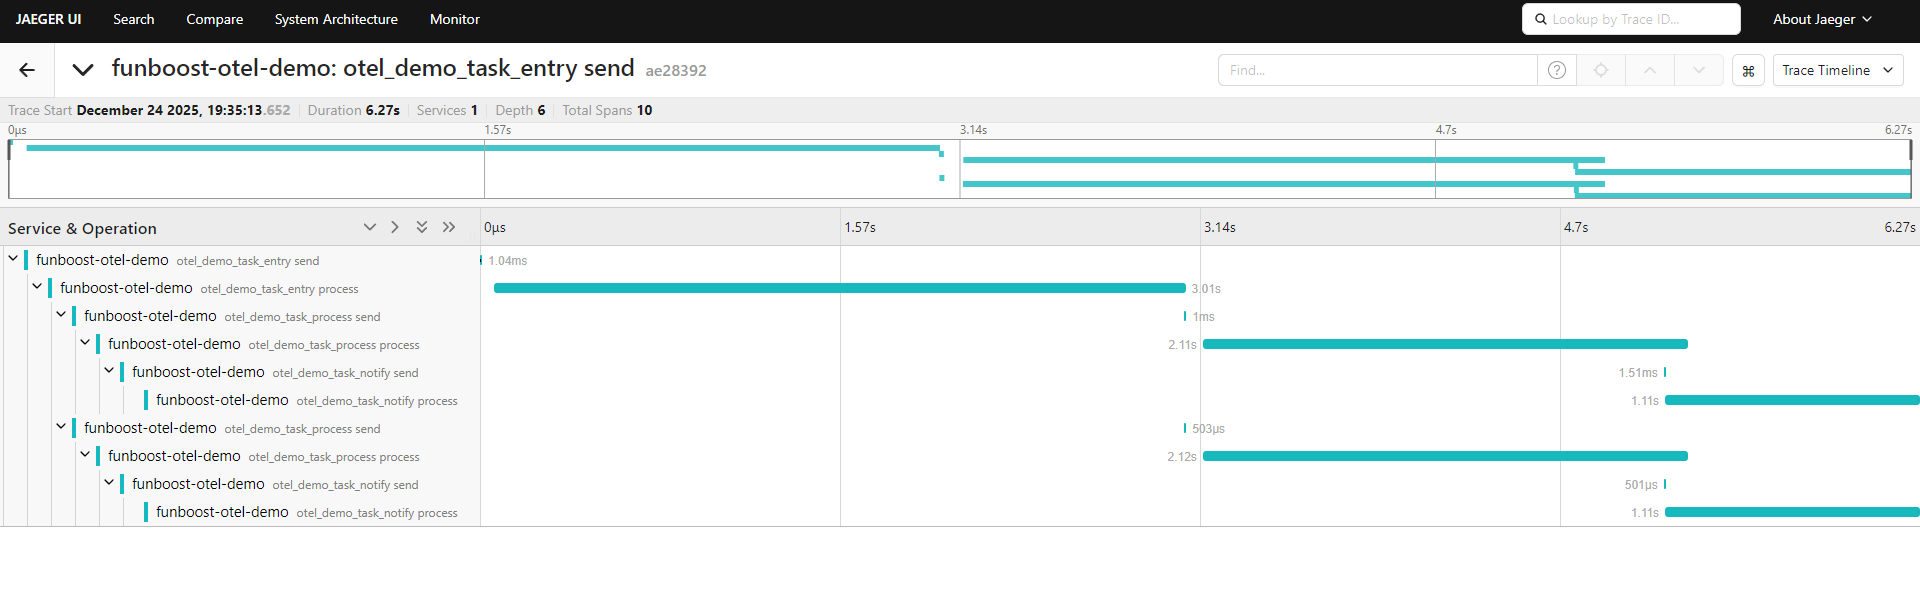
4b.7.2 opentelemetry 全链路任务追踪 和 logger日志 + task_id 的排查区别
一句话总结:logger + task_id 是"线性叙事"(侦探笔记),OpenTelemetry 是"上帝视角"(全息沙盘)。
维度 |
Logger + task_id |
OpenTelemetry |
|---|---|---|
视角 |
一维文本行 |
树状/甘特图 |
因果关系 |
需手动搜索关联 |
自动展示父子关系 |
性能分析 |
无法直观看延迟 |
一眼看到瓶颈 |
跨服务 |
割裂 |
自动串联 |
两者互补:TaskIdLogger 让你在日志里不迷路,OtelBoosterParams 让你拥有上帝视角。
4b.7.3 从opentelemetry功能集成,侧面证明 funboost 对普通用户扩展性远强于celery
funboost 通过 4.21 章节介绍的 consumer_override_cls + publisher_override_cls 机制,仅一个文件 funboost_otel_mixin.py 就实现了 opentelemetry 集成。
funboost 扩展方式:经典 OOP 继承,self.xx 访问任何属性,fct 获取当前任务状态。用户可 100% 修改定制任何细节。
Celery 扩展方式对比:需要连接 12 个信号钩子(before_task_publish、task_prerun、task_postrun、task_failure 等),且 span 对象需要跨函数"偷渡"。事实上 Celery 的 opentelemetry 集成需要 opentelemetry 官方团队和 Celery 官方两方合作开发。
Celery opentelemetry 源码: opentelemetry-instrumentation-celery
4b.8 funboost 声明式任务编排 workflow
tips:用户可对比 4b.5 章节的命令式编排。
类似 Celery Canvas 的声明式 API,降低学习成本。
4b.8.1 快速开始
import time
from funboost import boost, BrokerEnum
from funboost.workflow import chain, group, chord, WorkflowBoosterParams

@boost(WorkflowBoosterParams(queue_name='download_task', broker_kind=BrokerEnum.REDIS))
def download(url):
    time.sleep(1)
    return f'/downloads/{url}'

@boost(WorkflowBoosterParams(queue_name='process_task', broker_kind=BrokerEnum.REDIS))
def process(file_path, resolution='360p'):
    time.sleep(2)
    return f'{file_path}_{resolution}'

@boost(WorkflowBoosterParams(queue_name='notify_task', broker_kind=BrokerEnum.REDIS))
def notify(results, url):
    time.sleep(1)
    return f'完成: {url} -> {results}'

if __name__ == '__main__':
    download.consume()
    process.consume()
    notify.consume()

    workflow = chain(
        download.s('video.mp4'),
        chord(
            group(process.s(resolution=r) for r in ['360p', '720p', '1080p']),
            notify.s(url='video.mp4'),
        )
    )
    result = workflow.apply()
    print('工作流执行结果:', result)
4b.8.2 核心概念
原语 |
说明 |
用法 |
|---|---|---|
Signature |
任务签名 |
|
Chain |
链式执行,上游结果传给下游 |
|
Group |
并行执行,收集所有结果 |
|
Chord |
并行+汇总 |
|
4b.8.3 API 详解
# .s() - 可变签名(接收上游结果)
sig = download.s(url)

# .si() - 不可变签名(忽略上游结果)
sig = notify.si(msg)

# | 运算符 - 创建 chain
workflow = download.s(url) | process.s() | notify.s()
4b.8.4 WorkflowBoosterParams
预配置参数类,内置 is_using_rpc_mode=True + WorkflowPublisherMixin + WorkflowConsumerMixin:
from funboost.workflow import WorkflowBoosterParams

class MyParams(WorkflowBoosterParams):
    broker_kind: str = BrokerEnum.REDIS_ACK_ABLE
    max_retry_times: int = 3
4b.8.5 与 Celery Canvas 对比
功能 |
Celery |
Funboost Workflow |
|---|---|---|
链式 |
|
|
并行 |
|
|
汇总 |
|
|
Pipe |
|
|
不可变 |
|
|
4b.8.6 与 Funboost 命令式编排对比
维度 |
命令式 (RPC) |
声明式 (Workflow) |
|---|---|---|
代码量 |
较多 |
更少 |
灵活性 |
更高(可加 if/else) |
固定模式 |
适用场景 |
复杂条件逻辑 |
标准化流水线 |
4b.8.7 文件结构
funboost/workflow/
├── __init__.py          # 入口 + 猴子补丁
├── signature.py         # Signature 类
├── primitives.py        # Chain/Group/Chord
├── workflow_mixin.py    # Publisher/Consumer Mixin
├── params.py            # WorkflowBoosterParams
└── examples/
    └── video_pipeline.py  # 完整示例
4b.8.8 完整示例
4b.9 funboost 支持 prometheus 指标监控(高级功能)
funboost 内置了 MetricCalculation 指标统计(显示在 funweb 界面),同时也支持 prometheus 指标监控以对接 grafana 运维系统。
4b.9.0 Funboost Prometheus 监控指标 Mixin
支持两种模式:
HTTP Server 模式(单进程)— Prometheus 主动拉取
Push Gateway 模式(多进程)— 主动推送到 Pushgateway
4b.9.1 用法1:HTTP Server 模式(单进程)
from funboost import boost
from funboost.contrib.override_publisher_consumer_cls.funboost_promethus_mixin import (
    PrometheusBoosterParams, start_prometheus_http_server
)

start_prometheus_http_server(port=8000)

@boost(PrometheusBoosterParams(queue_name='my_task'))
def my_task(x):
    return x * 2

my_task.consume()
4b.9.2 用法2:Push Gateway 模式(多进程推荐)
from funboost import boost
from funboost.contrib.override_publisher_consumer_cls.funboost_promethus_mixin import (
    PrometheusPushGatewayBoosterParams,
)

@boost(PrometheusPushGatewayBoosterParams(
    queue_name='my_task',
    user_options={
        'prometheus_pushgateway_url': 'localhost:9091',
        'prometheus_push_interval': 10.0,
        'prometheus_job_name': 'my_app',
    }
))
def my_task(x):
    return x * 2

my_task.consume()
4b.9.3 指标说明
指标名 |
说明 |
|---|---|
|
任务计数 (labels: queue, status) |
|
任务耗时直方图 |
|
重试次数计数 |
|
队列剩余消息数量 |
|
发布消息计数 |
4b.10 funboost支持微批消费
微批核心:生产者单条提交,消费者自动聚合多条后批量处理。适用于批量写入数据库、批量调用 API。
重写
_submit_task累积消息到缓冲区达到
batch_size或超过timeout触发批量处理成功批量 ack,失败批量 requeue
消费函数入参从单个对象变为
list[dict]
4b.10.1 funboost 微批消费用法
代码位置: funboost/contrib/override_publisher_consumer_cls/funboost_micro_batch_mixin.py
from funboost import boost, BrokerEnum
from funboost.contrib.override_publisher_consumer_cls.funboost_micro_batch_mixin import MicroBatchBoosterParams

@boost(MicroBatchBoosterParams(
    queue_name='test_micro_batch_queue',
    broker_kind=BrokerEnum.MEMORY_QUEUE,
    user_options={
        'micro_batch_size': 10,
        'micro_batch_timeout': 3.0,
    },
))
def batch_insert_task(items: list):
    """items 是 [{'x': 10, 'y': 20}, {'x': 11, 'y': 22}, ...] """
    print(f"批量处理 {len(items)} 条消息: {items}")
    return len(items)


if __name__ == '__main__':
    batch_insert_task.consume()
    for i in range(25):
        batch_insert_task.push(x=i, y=i * 2)
4b.10.2 如果每次临时手写微批操作,会怎么样?
手写微批需考虑缓冲聚合、超时检测、线程安全,写不好会丢失尾部数据。微批消费为了超时强制触发,100% 需要独立的后台检查机制(线程或协程)。
4b.12 funboost的周期额度功能
周期额度:在指定周期内限制执行次数,周期结束后配额自动重置。
周期额度 ≠ 匀速执行。例如"每天24次"不代表每小时1次,你可以一口气用完24次额度。
周期额度可以和 qps 参数结合使用:qps 控制间隔频率,周期额度控制总次数。
4b.12.2 周期额度用法例子
from funboost import boost, BoosterParams, BrokerEnum
from funboost.contrib.override_publisher_consumer_cls.periodic_quota_mixin import PeriodicQuotaConsumerMixin

@boost(BoosterParams(
    queue_name='minute_quota_queue',
    broker_kind=BrokerEnum.REDIS,
    consumer_override_cls=PeriodicQuotaConsumerMixin,
    user_options={
        'quota_limit': 6,           # 每周期最多6次
        'quota_period': 'm',        # 周期为分钟 (s/m/h/d)
        'sliding_window': True,     # 滑动窗口(默认)
    },
    qps=1,
))
def my_task(x):
    print(f'Processing {x}')
对比 Celery:Celery 的
rate_limit='6/m'强制每 10 秒执行一次(匀速),funboost 的周期额度允许一分钟内任意时间用完 6 次。
4b.13 使用内存队列 broker_kind=BrokerEnum.MEMORY_QUEUE 时候,用 get_future 获取消费函数的运行结果
funboost RPC 通常使用 Redis 作为载体。对于内存队列(MEMORY_QUEUE),为了高性能且支持不可 pickle 序列化的结果,额外提供了:
get_future→ 返回concurrent.futures.Futureget_aio_future→ 返回asyncio.Future
import time
import asyncio
import concurrent.futures
from funboost import boost, BoosterParams, BrokerEnum, ConcurrentModeEnum

@boost(BoosterParams(queue_name="simple_demo_queue", broker_kind=BrokerEnum.MEMORY_QUEUE, qps=2, concurrent_num=10))
def simple_task(x, y):
    time.sleep(1)
    return x + y

@boost(BoosterParams(queue_name="async_demo_queue", broker_kind=BrokerEnum.MEMORY_QUEUE,
                     concurrent_mode=ConcurrentModeEnum.ASYNC, qps=2, concurrent_num=10))
async def async_task(x, y):
    await asyncio.sleep(1)
    return x + y


def sync_rpc_demo():
    for i in range(3):
        future: concurrent.futures.Future = simple_task.publisher.get_future(i, i * 2)
        result_status = future.result(timeout=10)
        print(f'任务 {i} 结果: {result_status.result}, 成功: {result_status.success}')


async def async_rpc_demo():
    futures = [async_task.publisher.get_aio_future(i, i * 2) for i in range(3, 6)]
    for i, future in enumerate(futures, start=3):
        result_status = await future
        print(f'任务 {i} 结果: {result_status.result}, 成功: {result_status.success}')


if __name__ == '__main__':
    simple_task.consume()
    async_task.consume()
    sync_rpc_demo()
    asyncio.run(async_rpc_demo())
4b.14 funboost 支持自动熔断,智能自动熔断、半开、恢复(高级功能)
遵循业界标准三态状态机(Closed/Open/Half-Open),支持两种触发策略、两种计数后端(local/redis)、扩展钩子。
4b.14.0 funboost 支持自动熔断管理和手动熔断管理
4b.14.0.1 手动熔断管理
方式 |
操作说明 |
|---|---|
Redis 标志 |
|
FaaS 接口 |
|
Web 管理界面 |
Funboost Web Manager 网页操作 |
4b.14.0.2 自动熔断管理
通过 CircuitBreakerConsumerMixin 实现,智能自动进入 CLOSED → OPEN → HALF_OPEN 三种状态。
4b.14.1 funboost 自动熔断,CircuitBreakerConsumerMixin
源码:funboost/contrib/override_publisher_consumer_cls/circuit_breaker_mixin.py
4b.14.1.1 三态状态机
CLOSED(正常) → OPEN(熔断) → HALF_OPEN(半开试探) → CLOSED 或回退到 OPEN
流转路径 |
触发条件 |
|---|---|
CLOSED → OPEN |
连续失败或错误率超标 |
OPEN → HALF_OPEN |
经过 |
HALF_OPEN → CLOSED |
连续成功 >= |
HALF_OPEN → OPEN |
任意一次失败或超过 |
4b.14.1.2 两种触发策略
策略 |
说明 |
|---|---|
|
连续失败 >= |
|
滑动窗口内错误率 >= |
4b.14.1.3 两种计数后端
后端 |
适用场景 |
|---|---|
|
单机部署 |
|
分布式部署,多进程共享熔断状态 |
4b.14.1.4 两种熔断行为
模式 |
说明 |
|---|---|
阻塞模式(默认) |
熔断期间阻塞,消息留在中间件 |
Fallback 模式 |
用降级函数替代执行 |
4b.14.1.5 circuit_breaker_options 参数说明
参数 |
类型 |
默认值 |
说明 |
|---|---|---|---|
|
str |
|
触发策略 |
|
str |
|
计数后端 |
|
int |
|
连续失败次数阈值 |
|
float |
|
错误率阈值 |
|
float |
|
统计窗口秒数 |
|
int |
|
最少调用数 |
|
float |
|
熔断恢复等待秒数 |
|
int |
|
半开需连续成功次数 |
|
tuple/None |
|
跟踪的异常类型 |
|
callable/None |
|
降级函数 |
4b.14.1.6 钩子方法(子类重写)
方法 |
触发时机 |
用途 |
|---|---|---|
|
熔断触发时 |
发送告警 |
|
熔断恢复时 |
发送恢复通知 |
4b.14.1.7 用法示例
from funboost import boost, BoosterParams, BrokerEnum
from funboost.contrib.override_publisher_consumer_cls.circuit_breaker_mixin import (
    CircuitBreakerConsumerMixin, CircuitBreakerBoosterParams,
)

# 方式1:连续失败策略(最简用法)
@boost(CircuitBreakerBoosterParams(
    queue_name='my_task',
    broker_kind=BrokerEnum.REDIS,
    user_options={
        'circuit_breaker_options': {
            'failure_threshold': 5,
            'recovery_timeout': 60,
        }
    },
))
def my_task(x):
    return call_external_api(x)


# 方式2:错误率策略 + Redis 分布式计数
@boost(BoosterParams(
    queue_name='my_task_rate',
    broker_kind=BrokerEnum.REDIS,
    consumer_override_cls=CircuitBreakerConsumerMixin,
    user_options={
        'circuit_breaker_options': {
            'strategy': 'rate',
            'counter_backend': 'redis',
            'errors_rate': 0.5,
            'period': 60,
            'min_calls': 10,
            'recovery_timeout': 30,
            'exceptions': (ConnectionError, TimeoutError),
        }
    },
))
def my_task_rate(x):
    return call_external_api(x)


# 方式3:Fallback 降级模式
def my_fallback(x):
    return {'status': 'degraded', 'x': x}

@boost(BoosterParams(
    queue_name='my_task_fb',
    broker_kind=BrokerEnum.REDIS,
    consumer_override_cls=CircuitBreakerConsumerMixin,
    user_options={
        'circuit_breaker_options': {
            'failure_threshold': 3,
            'recovery_timeout': 30,
            'circuit_breaker_fallback': my_fallback,
        }
    },
))
def my_task_fb(x):
    return call_external_api(x)
4b.15 funboost 配置失败告警的多种方式
详见文档 6.30 章节:funboost 提供了多种灵活的失败告警方式,满足从业务级即时通知到运维级聚合监控的不同需求。